网络分层模型和应用协议
分层模型
五层网络模型
面对复杂的问题,可以使用分层的方式来简化。
经过不断的演化,网络最终形成了五层模型:
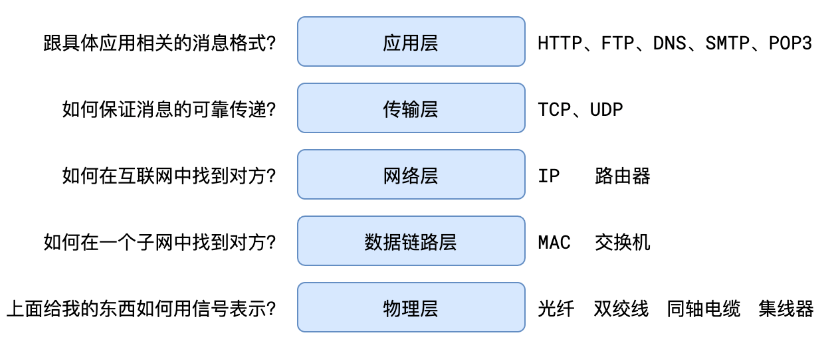
数据的传输
发送方从上到下将信息封装,每一层往信息内加入一些信息,最终发送出去,
接收方得到信息后,从下往上一层一层解封装,得到源信息。
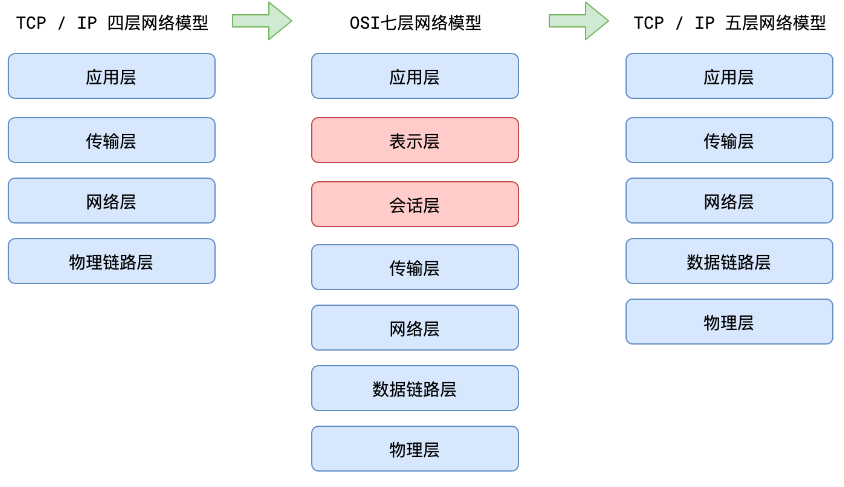
四层、五层、七层
应用层协议
URL
URL(uniform resource locator,统一资源定位符)用于定位网络服务
URL是一个固定格式的字符串
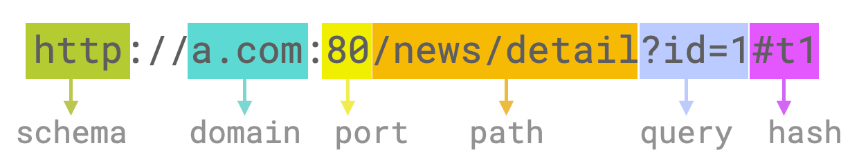
从网络中==哪台计算机(domain)==中的==哪个程序(port)==寻找==哪个服务(path)==,并注明了获取服务的==具体细节(path)==,以及要用什么样的==协议通信(schema)==
这里面包含了一些细节:
- 当协议是
http端口为80时,端口可以省略- 当协议是
https端口为443时,端口可以省略schema、domain、path是必填的,其他的根据具体的要求填写
URL 是 URI 的子集
HTTP
超文本传输协议(Hyper Text Transfer Protocol,HTTP)
该协议规定了两个方面的内容:
- 传递消息的模式
- 传递消息的格式
传递消息的模式
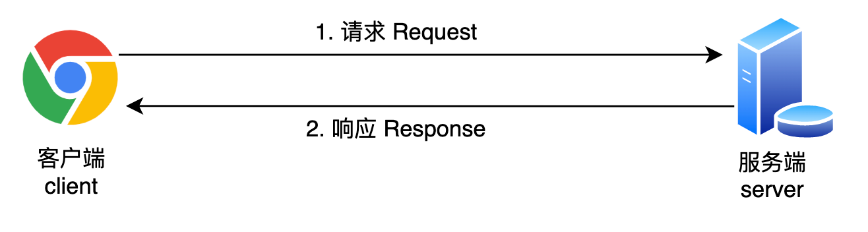
HTTP使用了一种极为简单的消息传递模式,「请求-响应」模式
发起请求的称之为客户端,接收请求并完成响应的称之为服务器。
「请求-响应」完成后,一次交互结束。
传递消息的格式
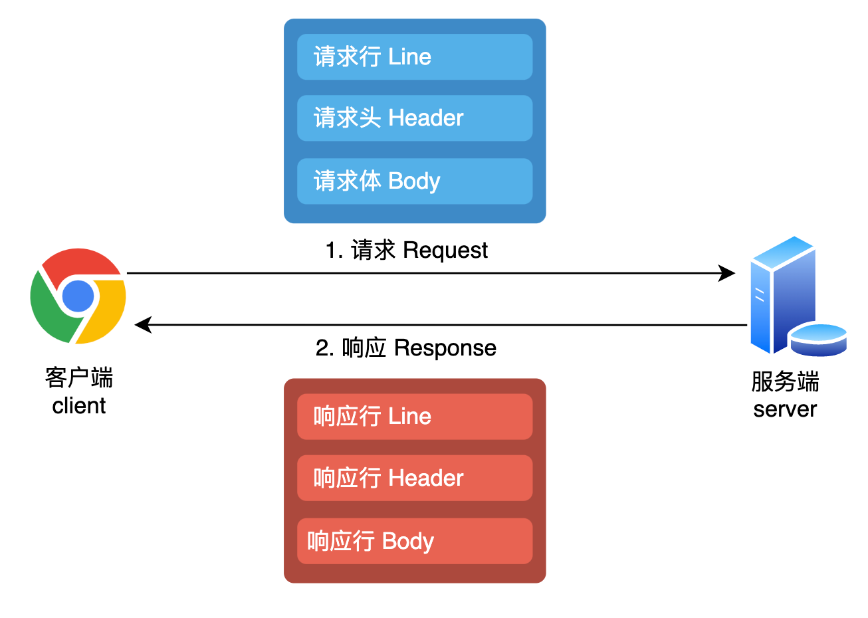
HTTP的消息格式是一种纯文本的格式,文本分为三个部分:
请求行
请求头

请求体
具体每一部分写什么内容,根据情况
关键信息
请求方法
请求行中的第一个单词是请求方法
在HTTP协议中,请求方法仅有语义的区别,只是表达了这次请求的「愿望」。
比如GET表达了客户端想要获取一些东西,POST表达了客户端想要提交一些东西
常见的请求方法有:
GET:获取POST:提交PUT:修改DELETE:删除
通常情况下:
- 获取数据一般使用
GET - 提交数据一般使用
POST - 各种静态资源的获取,一般使用
GET
请求头 - Host
Host标注了URL地址中的Domain + Port
Host: levin.ink
请求头 - Content-Type
Content-Type标注了附带的请求体是什么格式
如,请求体的数据为loginId:admin, loginPwd:123456,请求体可以用不同的格式发出
Content-Type: application/x-www-form-urlencoded

loginId=admin&loginPwd=123123
Content-Type: application/json

{ "loginId": "admin", "loginPwd": "123123" }
Content-Type: multipart/form-data; boundary=aaa

--aaa
Content-Disposition: form-data; name="loginId"

admin
--aaa
Content-Disposition: form-data; name="loginPwd"

123456
--aaa
Content-Disposition: form-data; name="avatar"; filename="small.jpg"
Content-Type: image/jpeg

文件的二进制
--aaa--
x/y MINE用于描述格式
image/png, image/gif, text/plain
响应码
响应码(状态码、消息码)是响应行中的一个数字,后面往往跟上一个对应的单词,用于表达服务器对这个响应的整体「态度」
常见的响应码有:
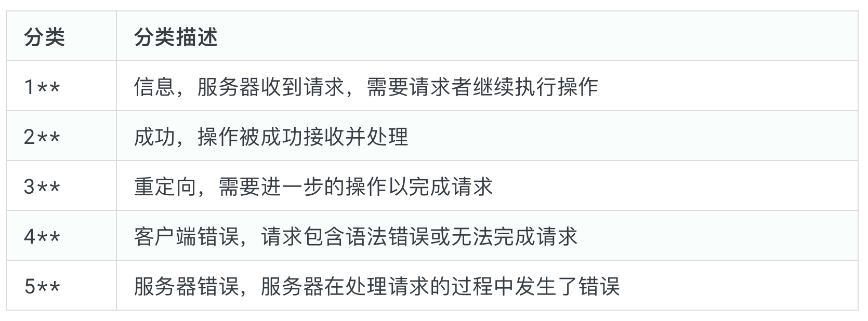
常见的状态码有:
- 200 OK:一切正常。
- 301 Moved Permanently:资源已被永久重定向。
资源地址在响应头中的Location中,浏览器会保存信息 - 302 Found:资源已被临时重定向。
浏览器会缓存 - 304 Not Modified:文档内容未被修改。
- 400 Bad Request:语义有误,当前请求无法被服务器理解。
- 403 Forbidden:服务器拒绝执行。
- 404 Not Found:资源不存在。
- 500 Internal Server Error:服务器内部错误。
响应头 - Content-Type
Content-Type标注了附带的响应体是什么格式
常见的值有:
text/plain: 普通的纯文本text/html:html文档text/javascript或application/javascript:js代码text/css:css代码image/jpeg:jpg图片attachment:附件- 其他
MIME类型
浏览器的通信能力
用户代理
浏览器可以代替用户完成http请求,代替用户解析响应结果,称之为用户代理 user agent
在网络层面浏览器拥有的两大核心能力:
- 自动发出请求的能力
- 自动解析响应的能力
自动发出请求的能力
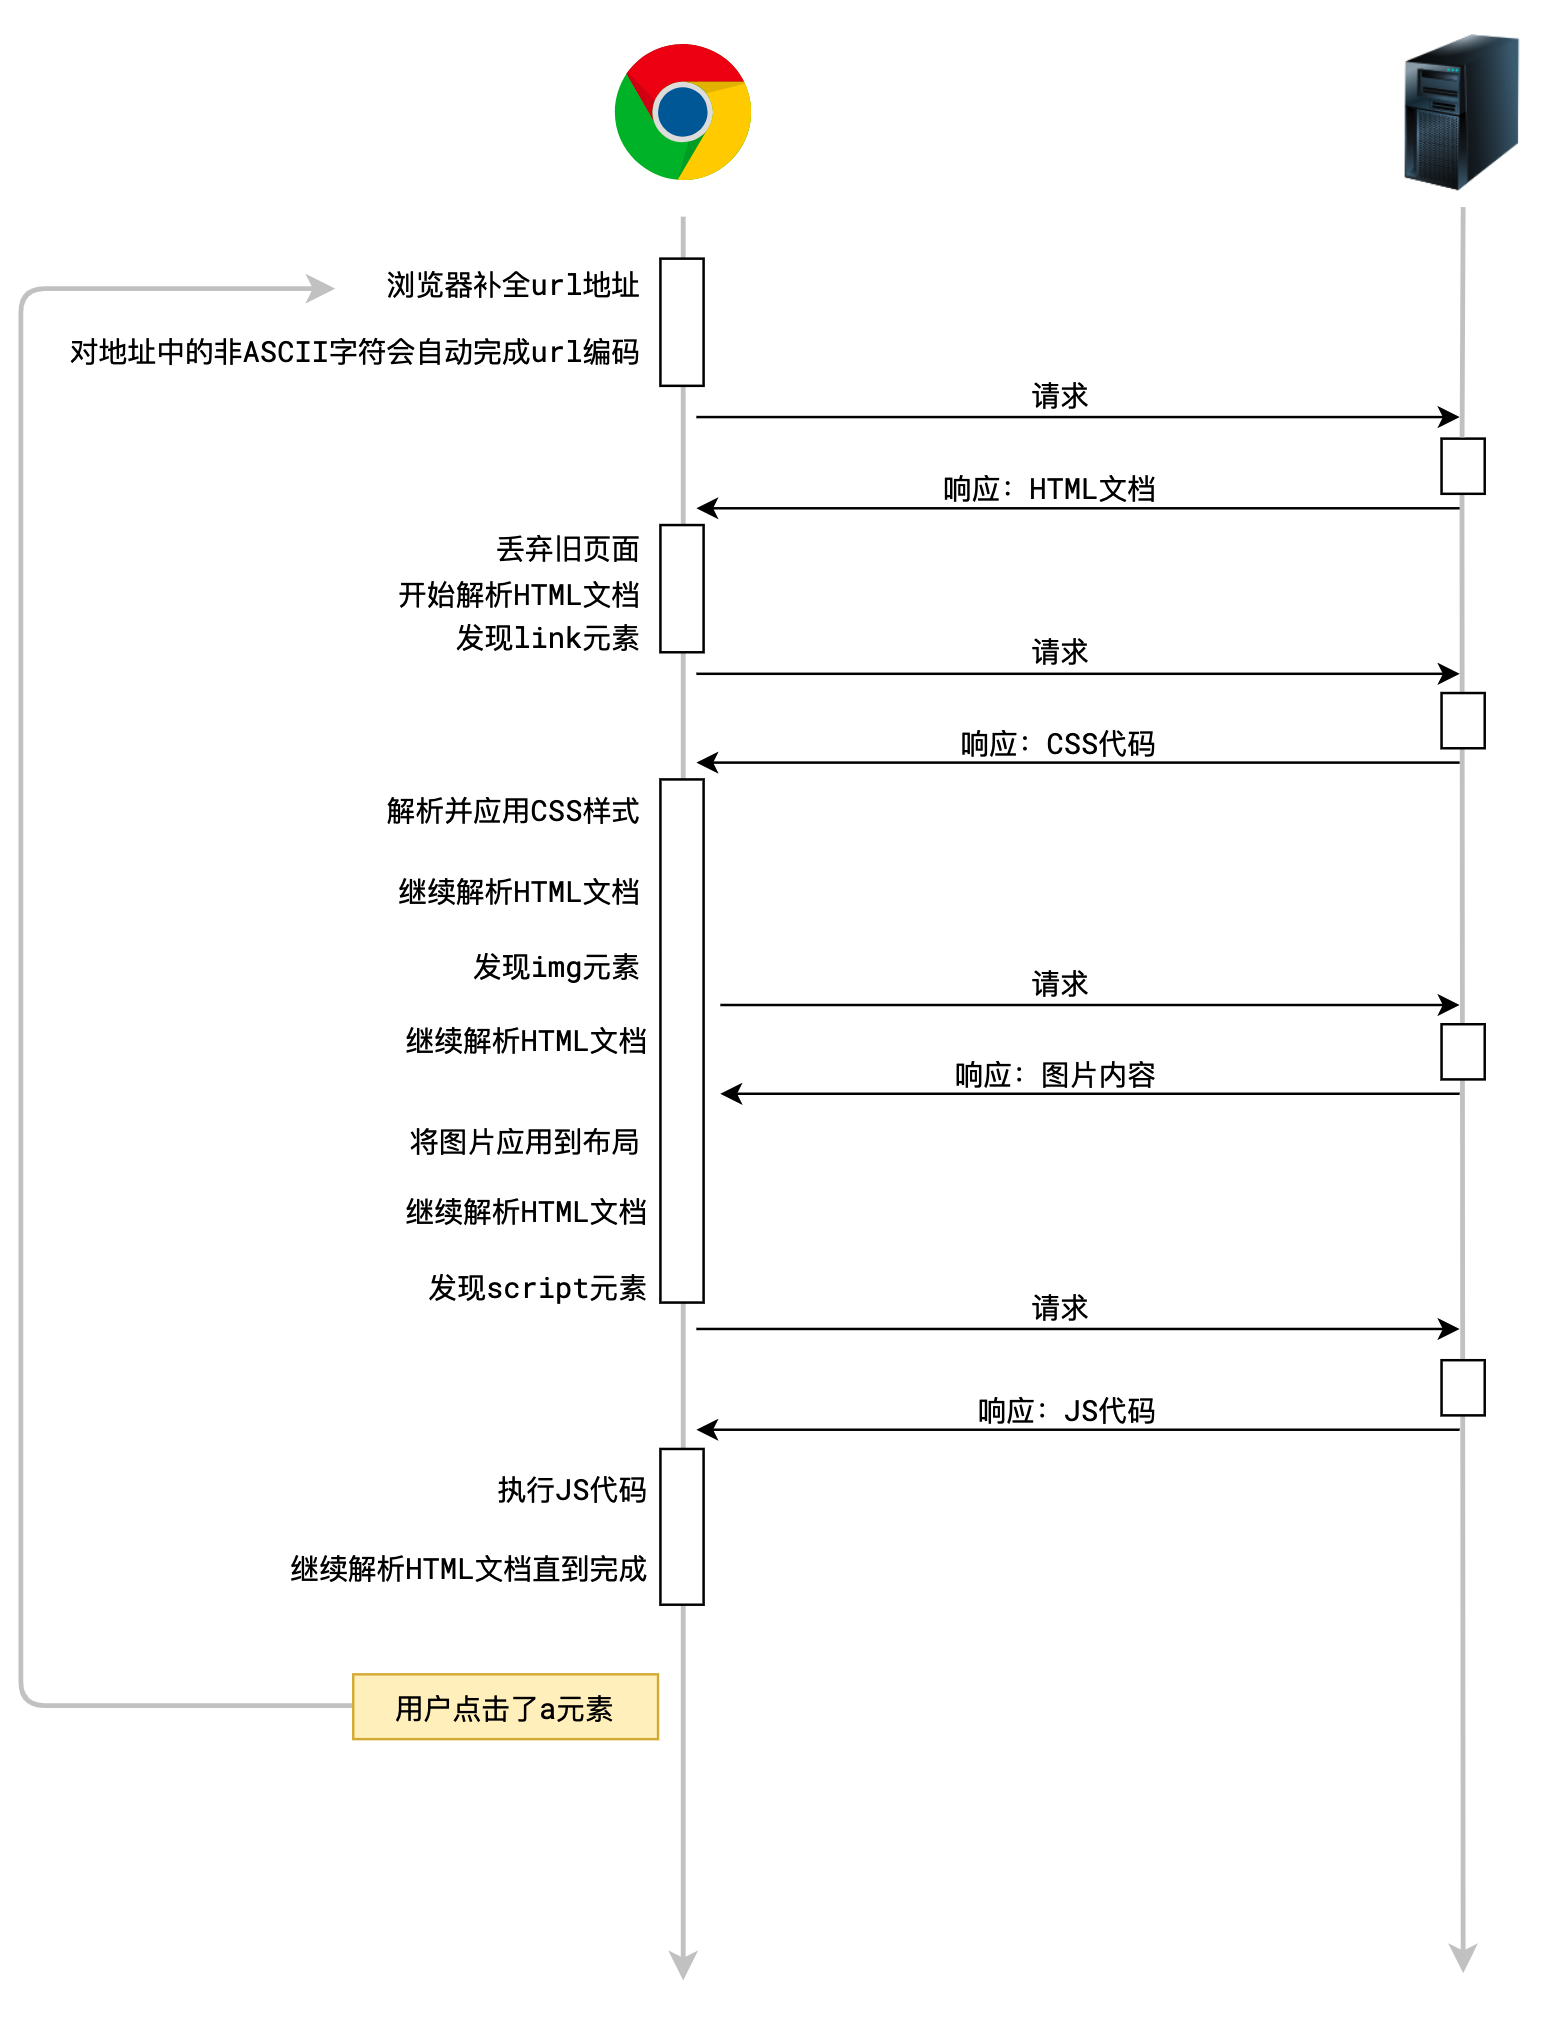
当一些事情发生的时候,浏览器会代替用户自动发出http请求,常见的包括:
- 用户在地址栏输入了一个url地址,并按下了回车
浏览器会自动解析URL,并发出一个GET请求,同时抛弃当前页面。 - 当用户点击了页面中的a元素
浏览器会拿到a元素的href地址,并发出一个GET请求,同时抛弃当前页面。
通常书写的地址并不是完整的url地址,浏览器会自动补全。
通常会使用当前页面的url信息来补全缺少的信息。
当前页面 https://levin.ink/a/b/1.html
绝对路径 /a/c/2.html -> https://levin.ink/a/c/2.html
相对路径 ./3.html -> https://levin.ink/a/b/3.html
        3.html -> https://levin.ink/a/b/3.html
        ../c/4.html -> https://levin.ink/a/c/4.html
- 当用户点击了提交按钮
<button type="submit">...</button>
浏览器会获取按钮所在的<form>元素,拿到它的action属性地址,同时拿到它method属性值,然后把表单中的数据组织到请求体中,发出指定方法的请求,同时抛弃当前页面。 - 当解析HTML时遇到了
<link> <img> <script> <video> <audio>等元素
浏览器会拿到对应的地址,发出GET请求 - 当用户点击了刷新
浏览器会拿到当前页面的地址,以及当前页面的请求方法,重新发一次请求,同时抛弃当前页面。
浏览器在发出请求时,会自动附带一些请求头
服务器和浏览器都有一个约定:
当发送GET请求时,不会附带请求体
由于前后端程序的默认行为,逐步造成了GET和POST的各种差异:
- 浏览器在发送 GET 请求时,不会附带请求体
- GET 请求的传递信息量有限,适合传递少量数据;POST 请求的传递信息量是没有限制的,适合传输大量数据。
- GET 请求只能传递 ASCII 数据,遇到非 ASCII 数据需要进行编码;POST 请求没有限制
- 大部分 GET 请求传递的数据都附带在 path 参数中,能够通过分享地址完整的重现页面,但同时也暴露了数据,若有敏感数据传递,不应该使用 GET 请求,至少不应该放到 path 中
- POST 不会被保存到浏览器的历史记录中
- 刷新页面时,若当前的页面是通过 POST 请求得到的,则浏览器会提示用户是否重新提交。若是 GET 请求得到的页面则没有提示。
自动解析响应的能力
浏览器不仅能发送请求,还能够针对服务器的各种响应结果做出不同的自动处理
- 识别响应码
浏览器能够自动识别响应码,当出现一些特殊的响应码时浏览器会自动完成处理,比如301、302 - 根据响应结果做不同的处理
浏览器能够自动分析响应头中的Content-Type,根据不同的值进行不同处理,比如:text/plain: 普通的纯文本,浏览器通常会将响应体原封不动的显示到页面上text/html:html文档,浏览器通常会将响应体作为页面进行渲染text/javascript或application/javascript:js代码,浏览器通常会使用JS执行引擎将它解析执行text/css:css代码,浏览器会将它视为样式image/jpeg:浏览器会将它视为jpg图片application/octet-stream:二进制数据,会触发浏览器下载功能attachment:附件,会触发下载功能
该值和其他值不同,应放到Content-Disposition头中。
基本流程
访问:https://levin.ink
AJAX
浏览器本身就具备网络通信的能力,但在早期,浏览器并没有把这个能力开放给JS。
最早是微软在IE浏览器中把这一能力向JS开放,让JS可以在代码中实现发送请求,并不会刷新页面,这项技术在2005年被正式命名为AJAX(Asynchronous Javascript And XML)
AJAX 就是指在web应用程序中异步向服务器发送请求。
它的实现方式有两种,XMLHttpRequest 简称XHR和Fetch
以下是两者的对比
| 功能点 | XHR | Fetch |
|---|---|---|
| 基本的请求能力 | ✅ | ✅ |
| 基本的获取响应能力 | ✅ | ✅ |
| 监控请求进度 | ✅ | ❌ |
| 监控响应进度 | ✅ | ✅ |
| Service Worker中是否可用 | ❌ | ✅ |
| 控制cookie的携带 | ❌ | ✅ |
| 控制重定向 | ❌ | ✅ |
| 请求取消 | ✅ | ✅ |
| 自定义referrer | ❌ | ✅ |
| 流 | ❌ | ✅ |
| API风格 | Event |
Promise |
| 活跃度 | 停止更新 | 不断更新 |
跨域问题及解决方案
同源策略及跨域问题
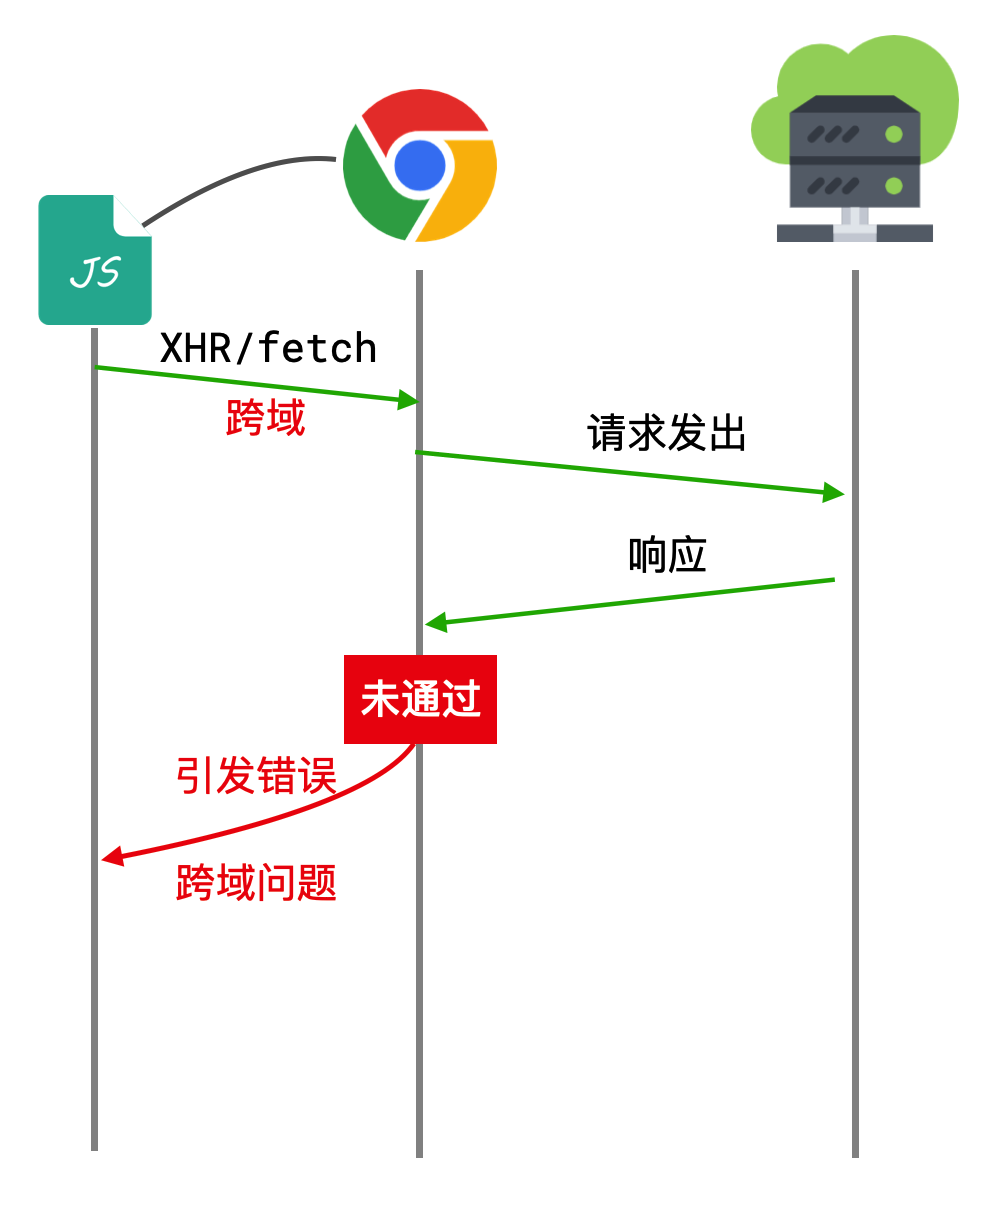
同源策略是一套浏览器安全机制,当一个源的文档和脚本,与另一个源的资源进行通信时,同源策略就会对这个通信做出不同程度的限制。
简单来说,同源策略对 同源资源 放行,对 异源资源 限制
因此限制造成的开发问题,称之为跨域(异源)问题
同源和异源
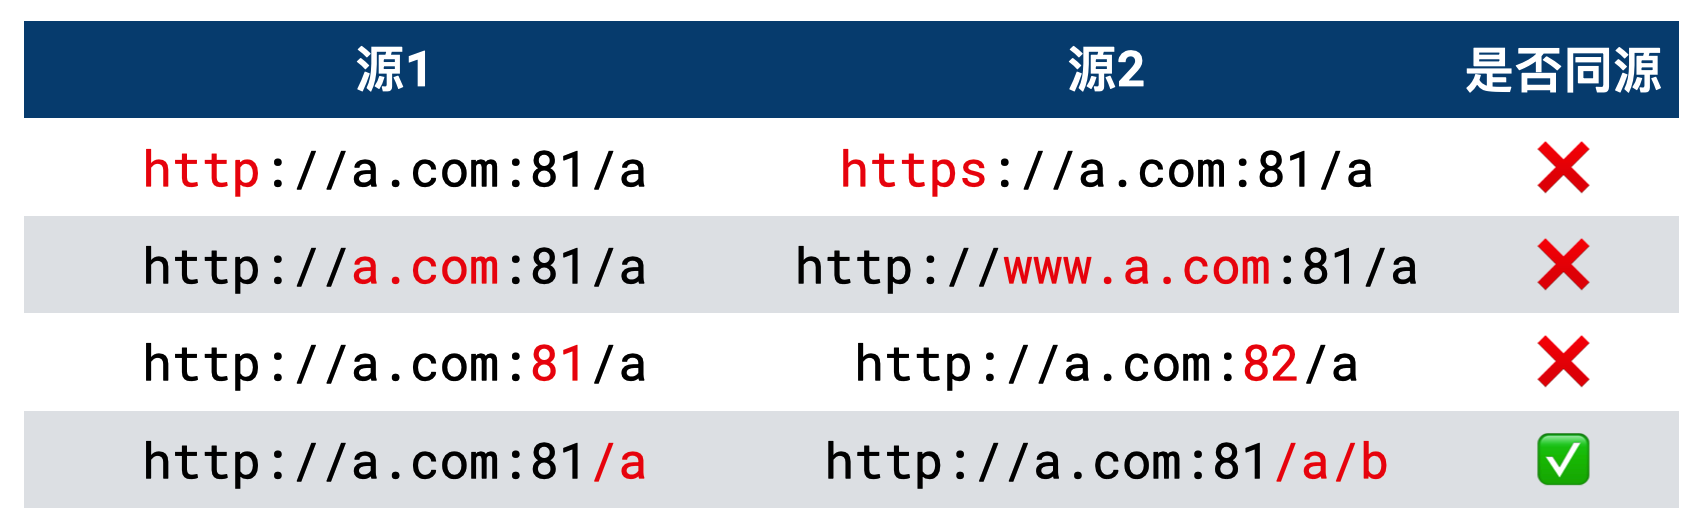
源(origin) = 协议 + 域名 + 端口
例如:
http://localhost:7001/index.html的源为http://localhost:7001
两个URL地址的源完全相同,则称之为同源,否则称之为异源(跨域)
跨域出现的场景
跨域可能出现在三种场景:
- 网络通信
a元素的跳转;加载css、js、图片等;AJAX等等 - JS API
window.open、window.parent、iframe.contentWindow等等 - 存储
WebStorage、IndexedDB等等
对于不同的跨域场景,以及每个场景中不同的跨域方式,同源策略都有不同的限制。
重点讨论网络通信中AJAX的跨域问题
网络中的跨域
当浏览器运行页面后,会发出很多的网络请求,例如CSS、JS、图片、AJAX等等
请求页面的源称之为页面源,在该页面中发出的请求称之为目标源。
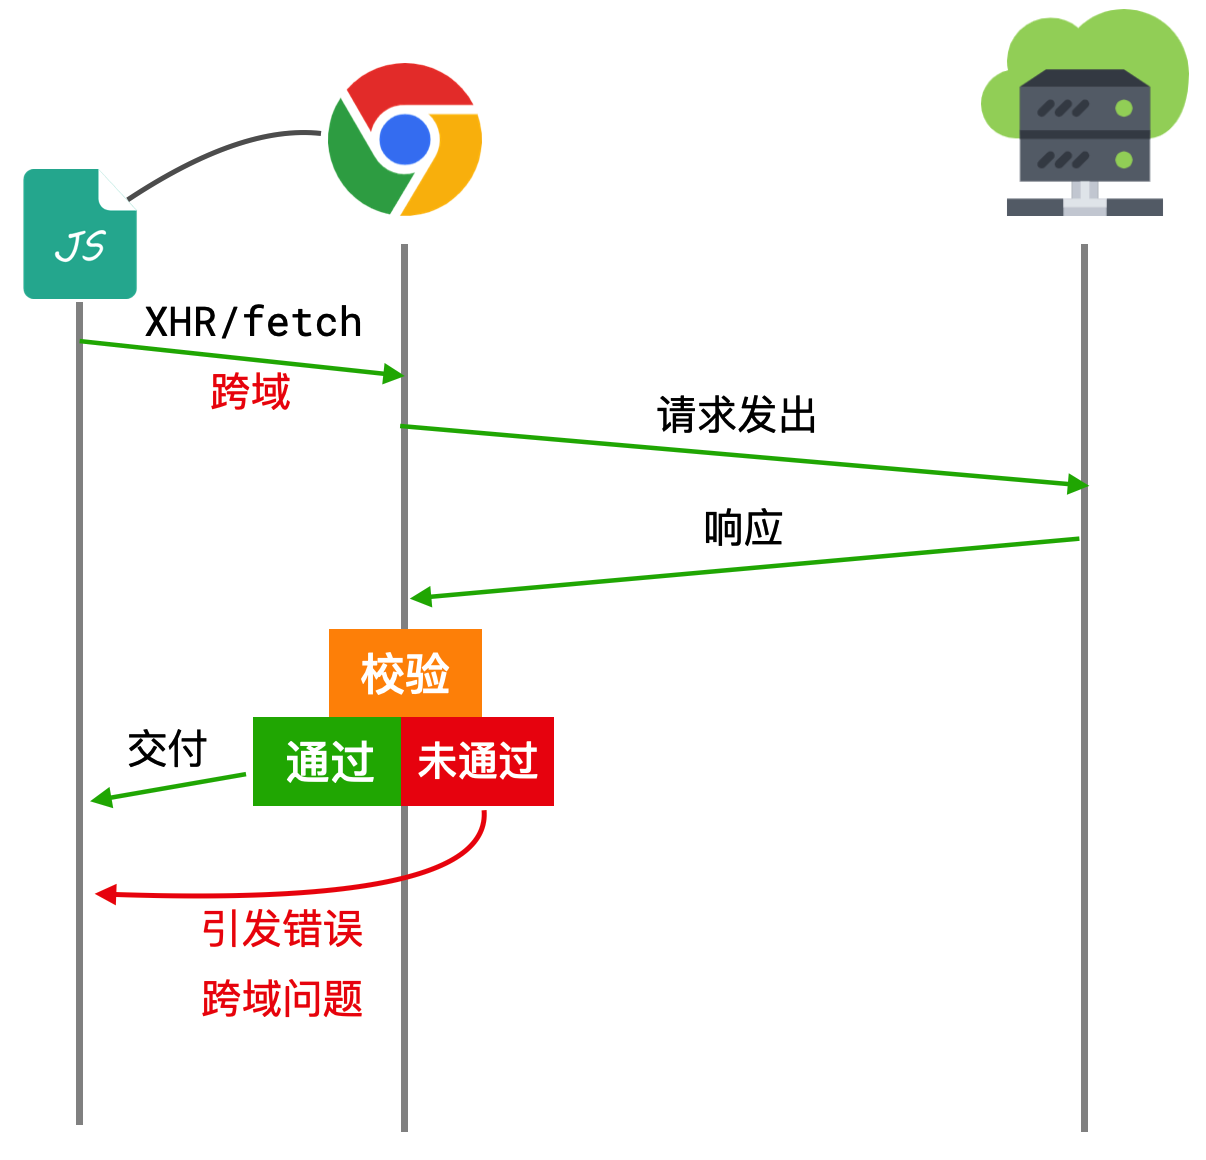
当页面源和目标源一致时,则为同源请求,否则为异源请求(跨域请求)
浏览器如何限制异源请求?
浏览器制定了非常繁杂的规则来限制各种跨域请求,但总体的原则非常简单:
- 对标签发出的跨域请求轻微限制
- 对AJAX发出的跨域请求严厉限制
解决方案
CORS
CORS(Cross-Origin Resource Sharing)是最正统的跨域解决方案,同时也是浏览器推荐的解决方案。
CORS是一套规则,用于帮助浏览器判断是否校验通过。
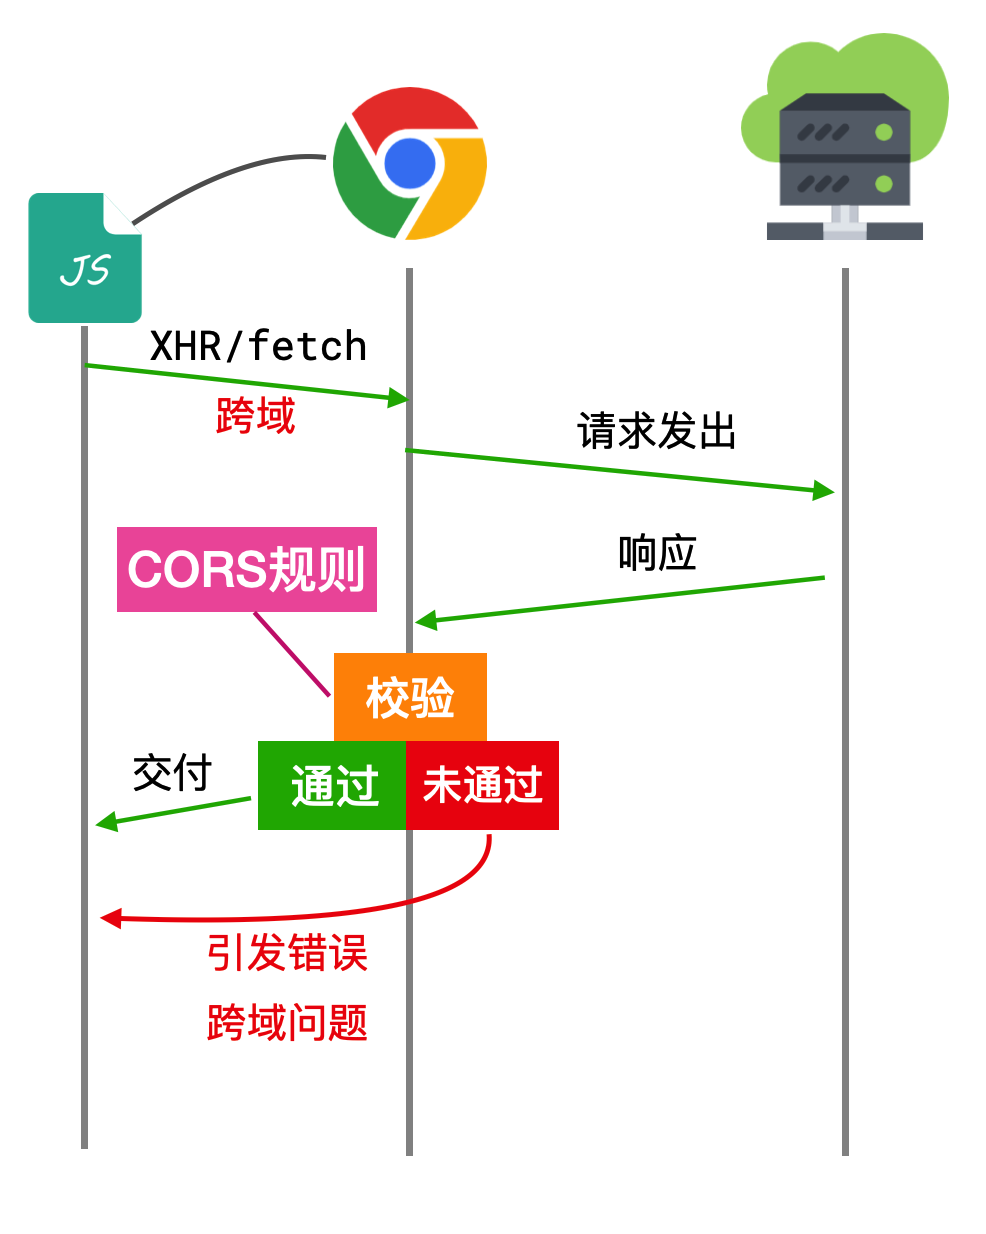
CORS的基本理念是:
- 只要服务器明确表示允许,则校验通过
- 服务器明确拒绝或没有表示,则校验不通过
所以,使用CORS解决跨域,必须要保证服务器是「自己人」
请求分类
CORS将请求分为两类:==简单请求==和==预检请求==。
对不同种类的请求它的规则有所区别。
简单请求
简单来说,只要全部满足下列条件,就是简单请求:
- 请求方法是
GET、POST、HEAD之一 - 头部字段满足CORS安全规范,详见 W3C
浏览器默认自带的头部字段都是满足安全规范的,只要开发者不改动和新增头部,就不会打破此条规则
- 如果有
Content-Type,必须是下列值中的一个text/plainmultipart/form-dataapplication/x-www-form-urlencoded
预检请求(preflight)
只要不是简单请求,均为预检请求
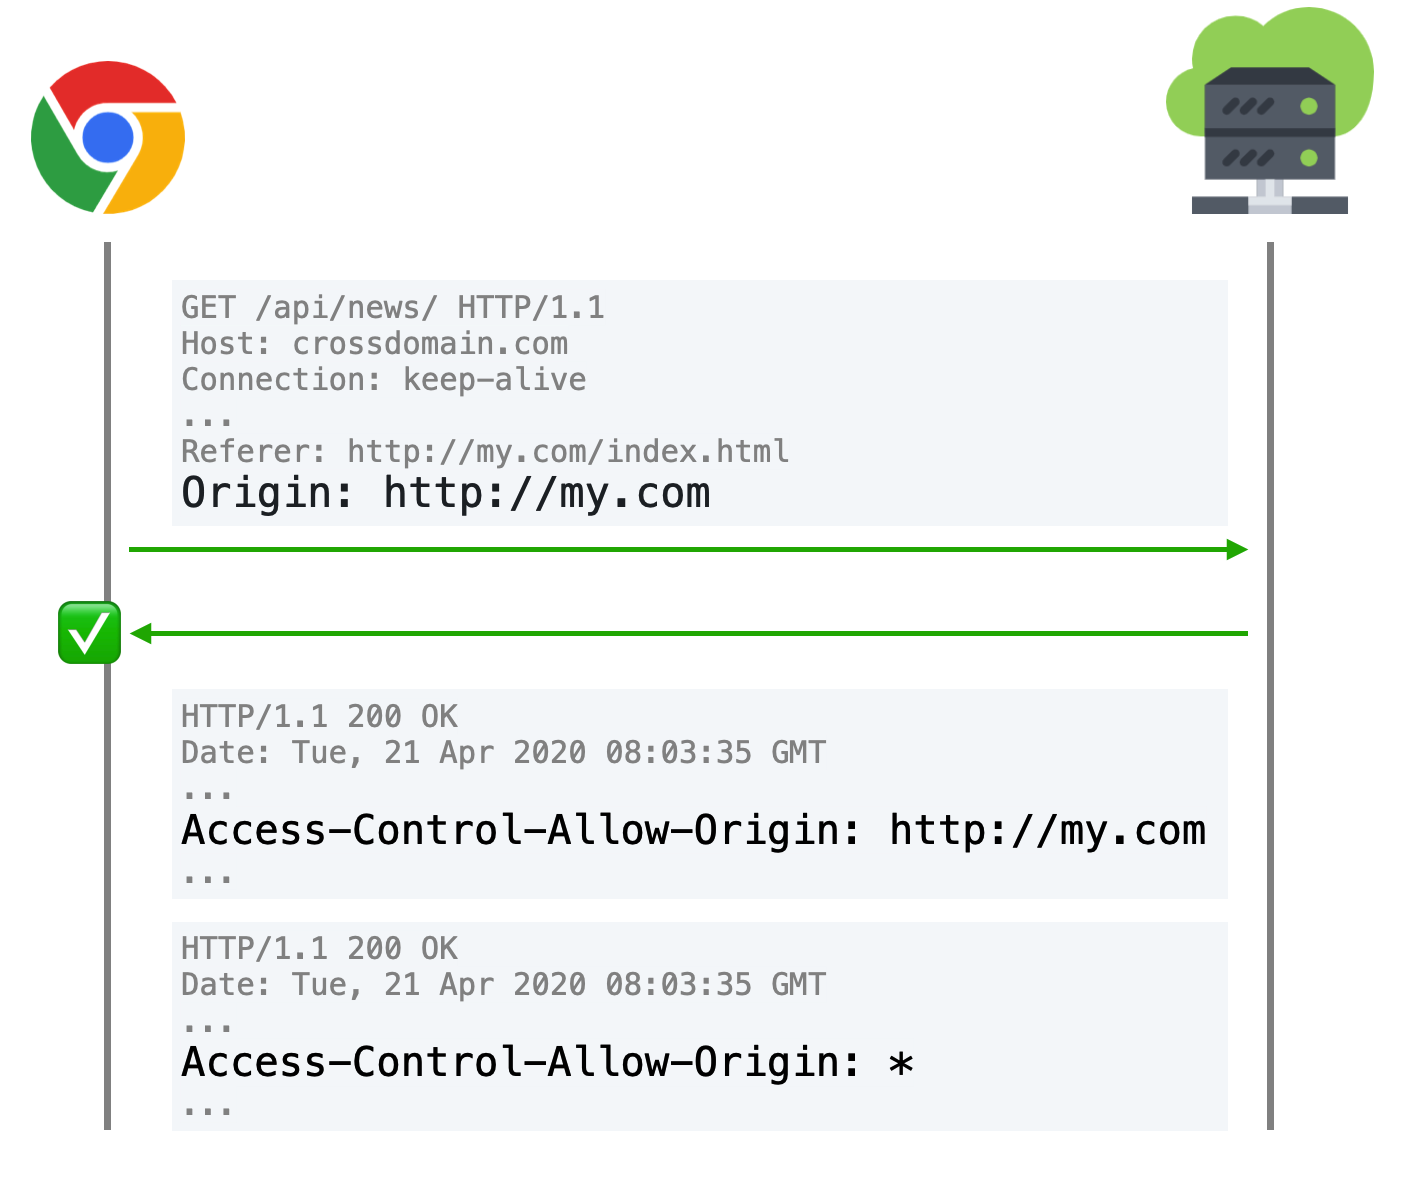
对简单请求的验证
浏览器带上一个请求头,发送到服务器,服务器只要返回表示运允许即可通过验证。
对预检请求的验证
- 发送预检请求
先发一个预检请求,只带上请求头,包括源,请求方法,改动的请求头,服务器返回允许源,方法,请求头,预检即可通过,可以设置缓存时间。

通过后继续第二步。 - 发送真实请求(和简单请求一致)

细节1 - 关于cookie
默认情况下,ajax的跨域请求并不会附带cookie,这样一来,某些需要权限的操作就无法进行
不过可以通过简单的配置就可以实现附带cookie
// xhr
var xhr = new XMLHttpRequest();
xhr.withCredentials = true;

// fetch api
fetch(url, {
  credentials: "include"
})
这样一来,该跨域的ajax请求就是一个附带身份凭证的请求
当一个请求需要附带cookie时,无论它是简单请求,还是预检请求,都会在请求头中添加cookie字段
而服务器响应时,需要明确告知客户端:服务器允许这样的凭据
告知的方式也非常的简单,只需要在响应头中添加:Access-Control-Allow-Credentials: true即可
对于一个附带身份凭证的请求,若服务器没有明确告知,浏览器仍然视为跨域被拒绝。
另外要特别注意的是:对于附带身份凭证的请求,服务器不得设置 Access-Control-Allow-Origin 的值为*。这就是为什么不推荐使用*的原因
细节2 - 关于跨域获取响应头
在跨域访问时,JS只能拿到一些最基本的响应头,如:Cache-Control、Content-Language、Content-Type、Expires、Last-Modified、Pragma,如果要访问其他头,则需要服务器设置本响应头。
Access-Control-Expose-Headers头让服务器把允许浏览器访问的头放入白名单,例如:
Access-Control-Expose-Headers: authorization, a, b
这样JS就能够访问指定的响应头了。
JSONP
在很久很久以前...并没有CORS方案
于是
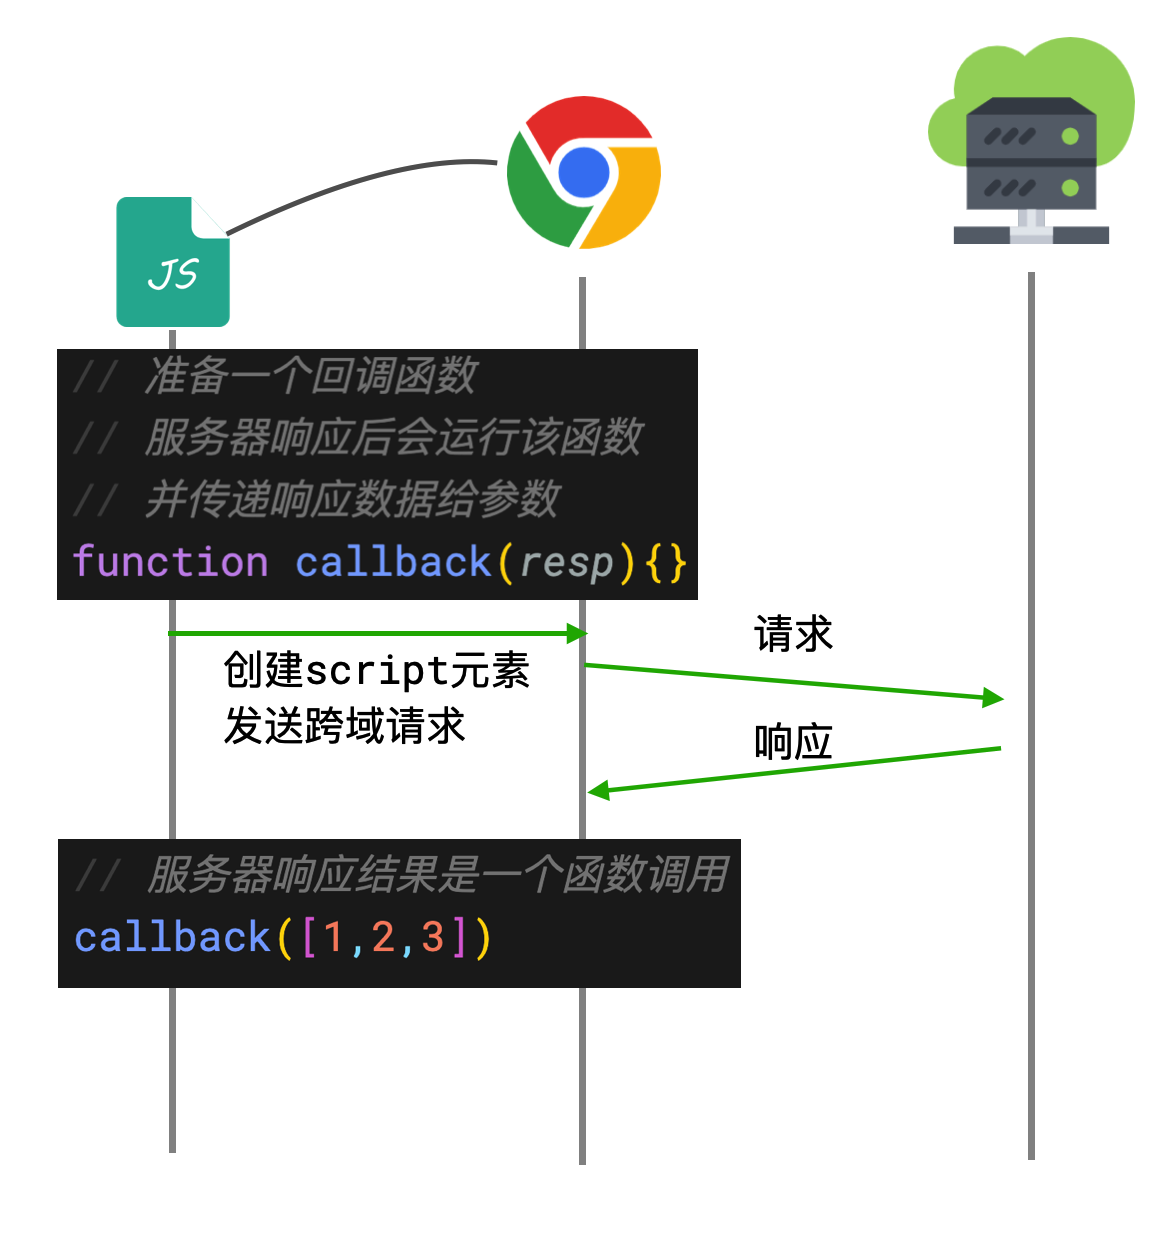
虽然可以解决问题,但JSONP有着明显的缺陷:
- 仅能使用GET请求
- 容易产生安全隐患
恶意攻击者可能利用
callback=恶意函数的方式实现XSS攻击
- 容易被非法站点恶意调用
因此,除非是某些特殊的原因,否则永远不应该使用JSONP
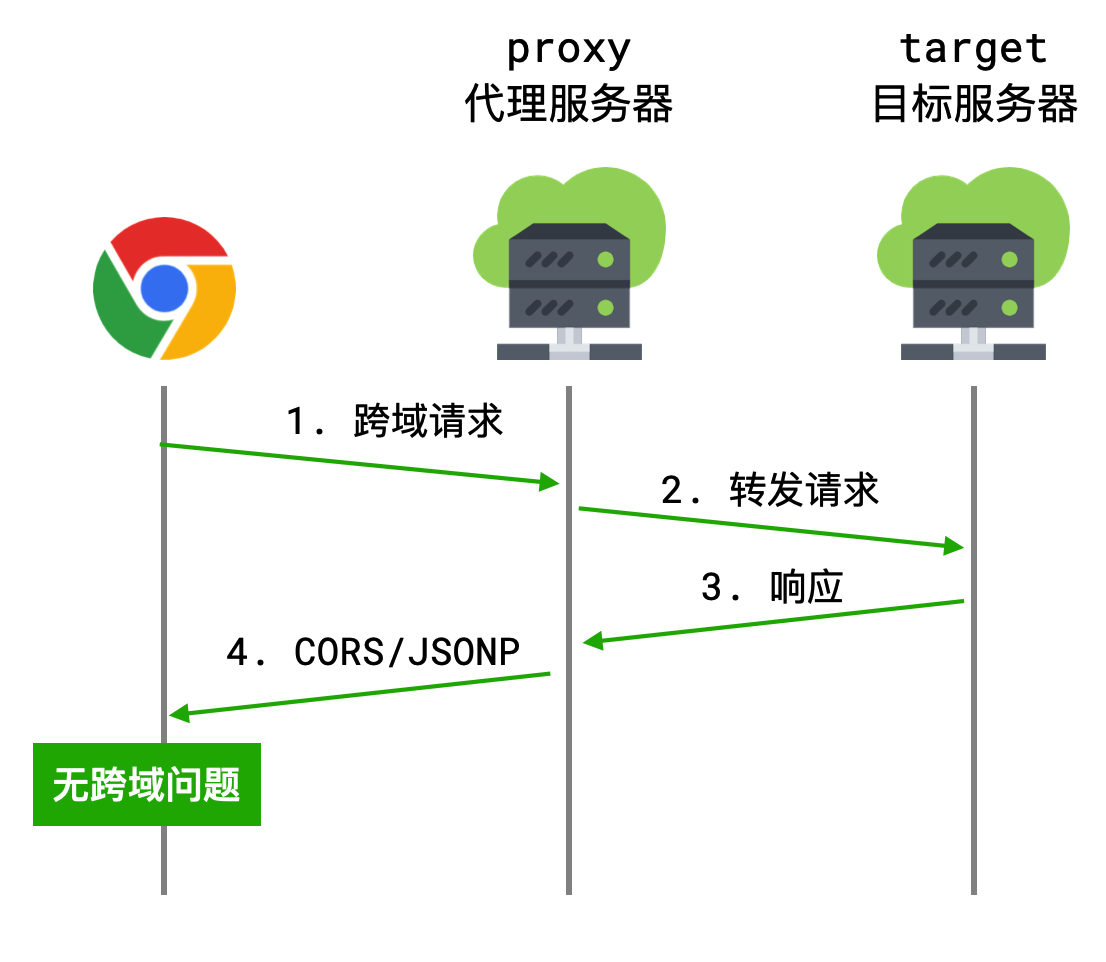
代理
CORS和JSONP均要求服务器是「自己人」
那如果不是呢?

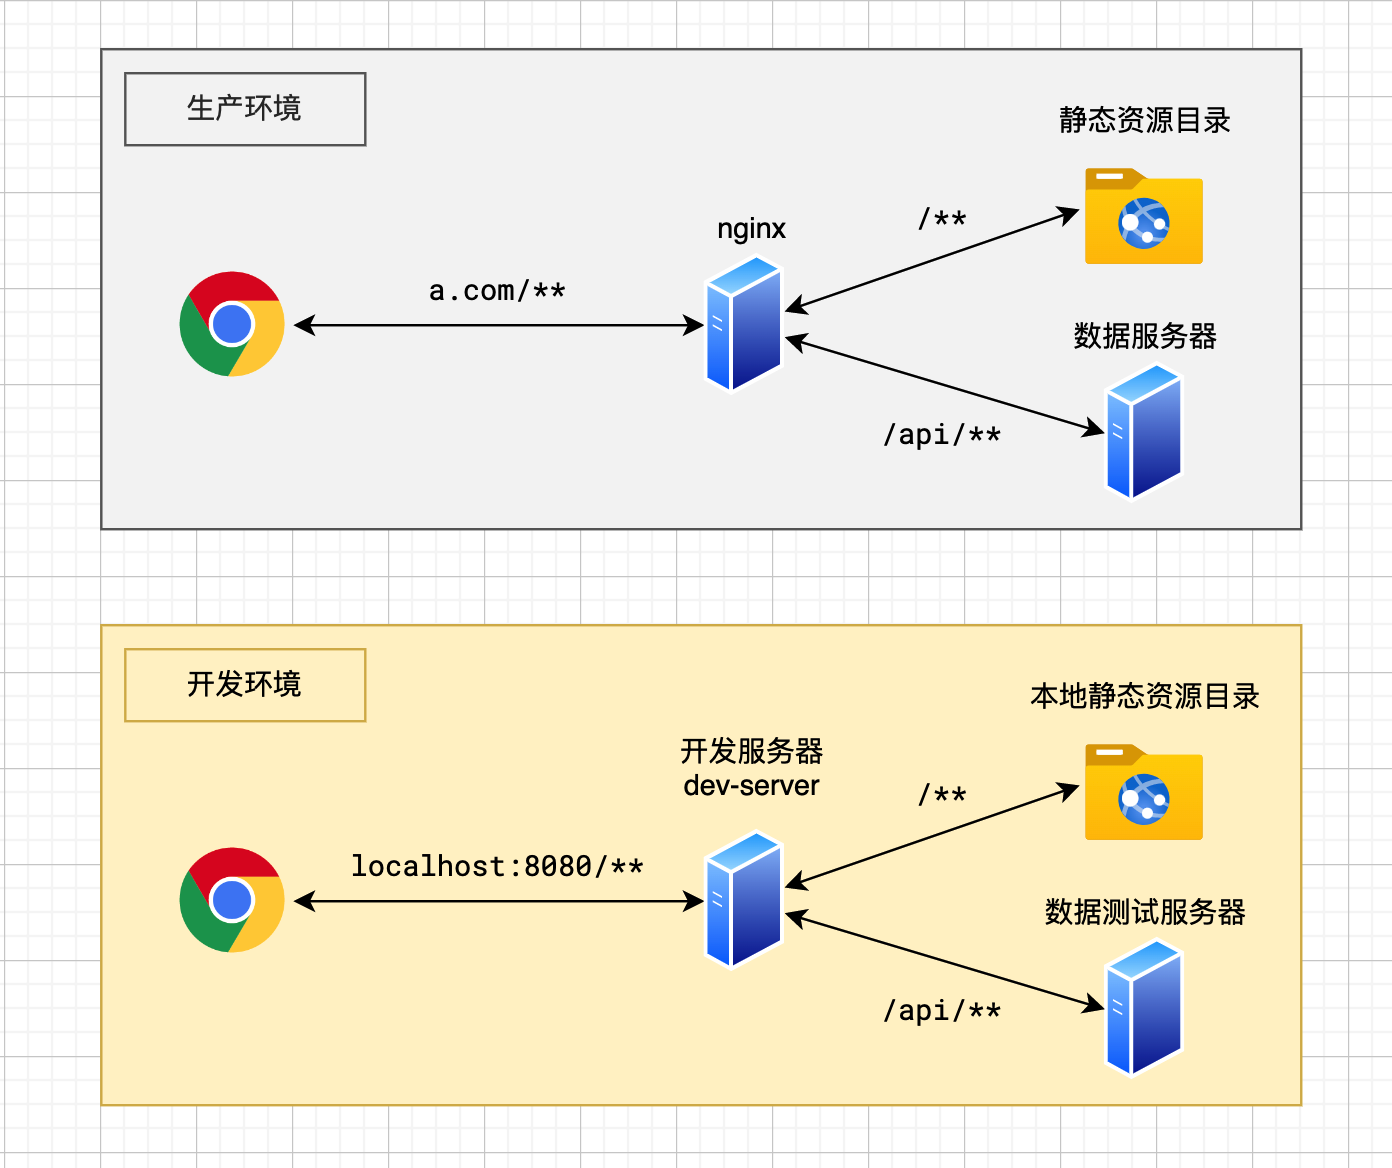
那就找一个中间人(代理)
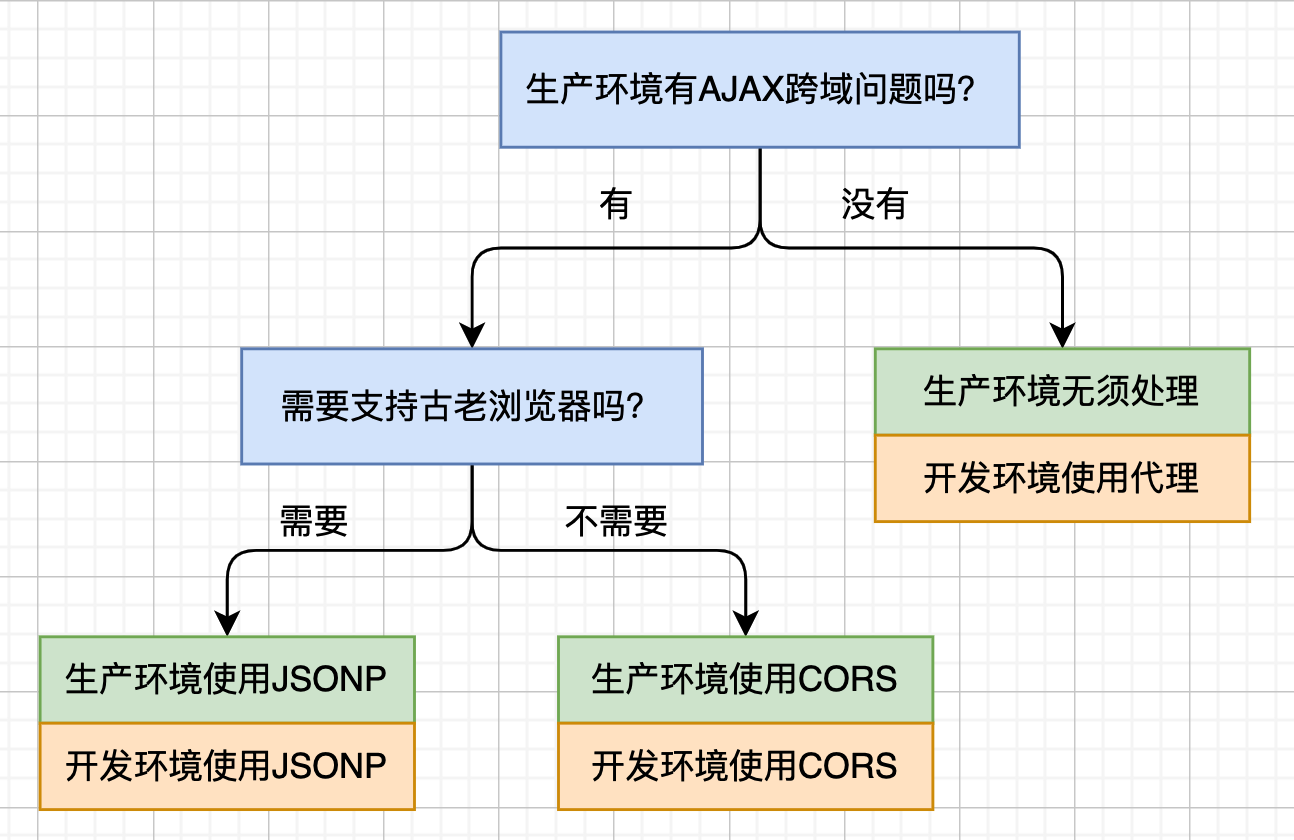
如何选择
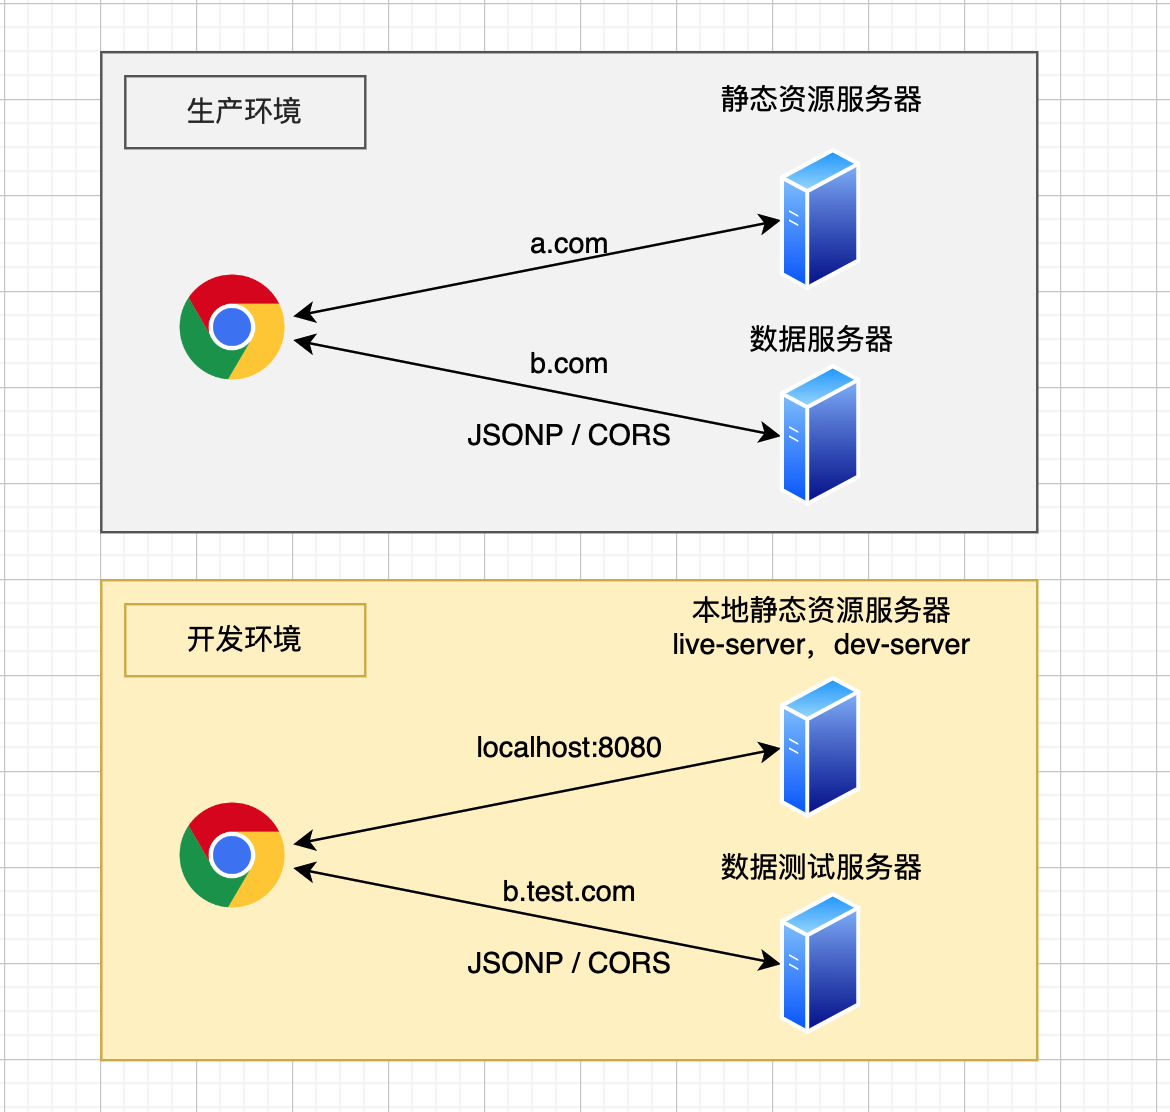
最重要的,是要保持生产环境和开发环境一致
下面是一张决策图
具体的几种场景